“온톨로지는 말로 풀어도 된다” 제네시스랩 CTO가 만든 슬립박스가 AI 에이전트 운영 방식을 바꾸는 이유
한눈에 보는 핵심 뉴스 포인트
- 온톨로지를 꼭 그래프 형태로만 만들 필요는 없고, 문장과 설명만으로도 충분히 운영 가능한 구조를 만들 수 있다는 관점이 나왔습니다.
- 제네시스랩은 딥러닝 10년 경험을 바탕으로, 내부 서비스들을 하나로 묶는 범용 Agent Builder를 만들고 있습니다.
- 핵심은 “개발자만 아는 AI”가 아니라, 현업 도메인 전문가가 직접 보고 수정하고 검증할 수 있는 운영 구조입니다.
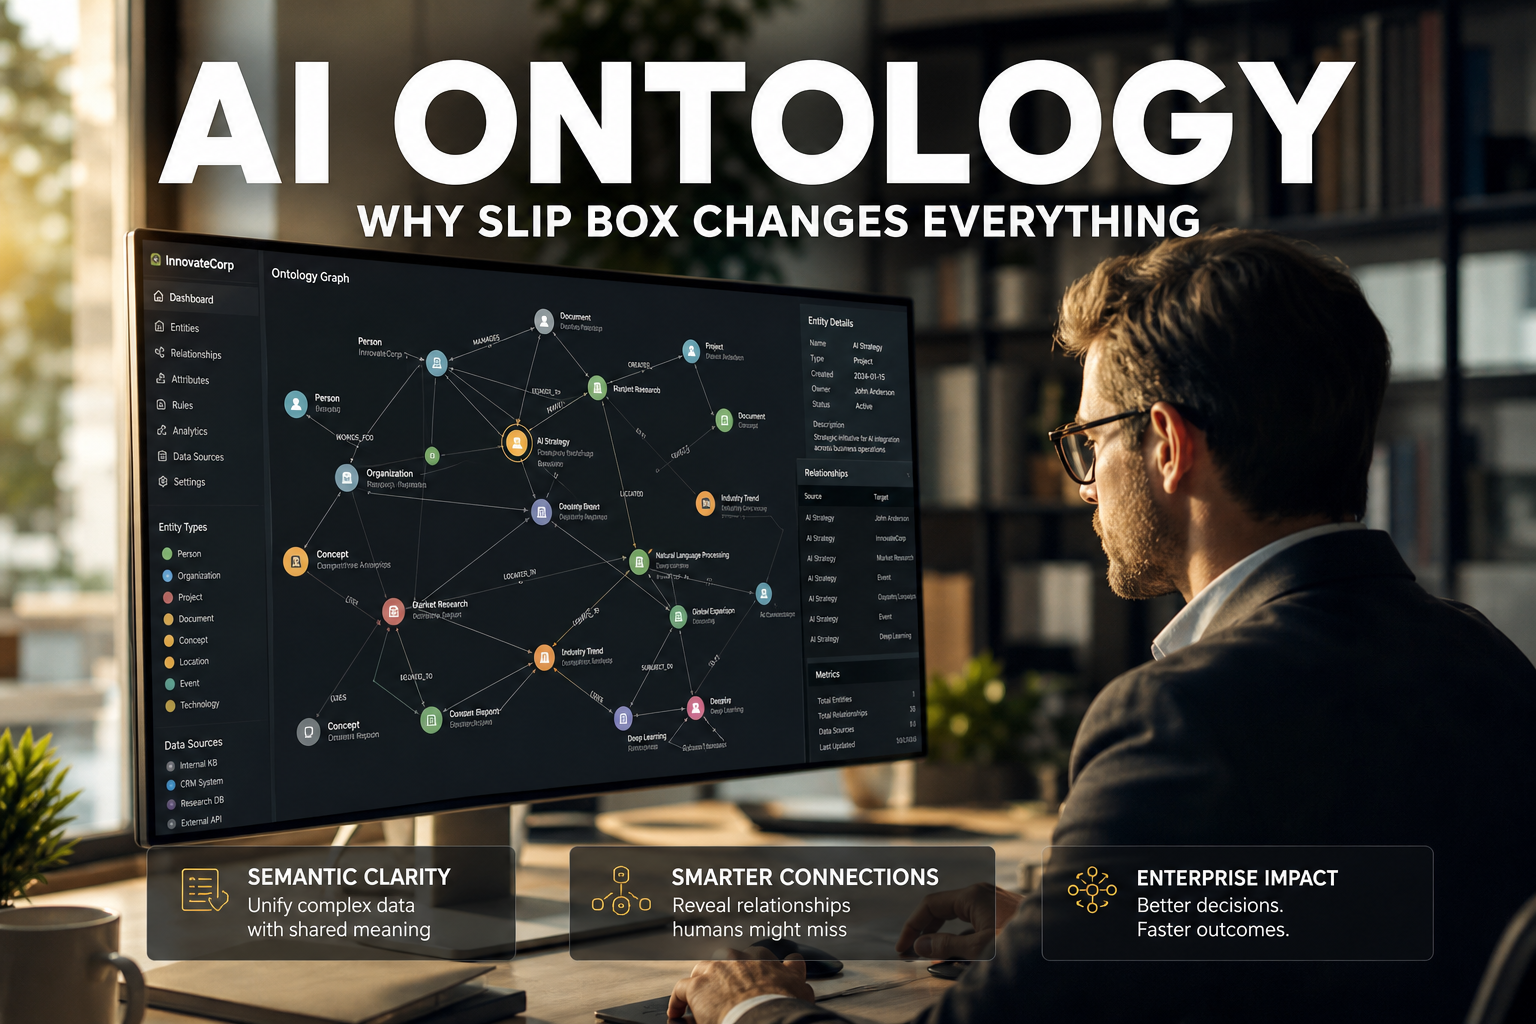
- 슬립박스는 단순한 지식 저장소가 아니라, AI가 이해하는 용어 정의, 관계 정의, 실행 흐름, 검증까지 연결하는 실전형 온톨로지에 가깝습니다.
- RAG, 벡터DB, Text-to-SQL, AI 에이전트, 데이터 거버넌스가 하나의 운영 체계로 묶이는 흐름이 보입니다.
- 특히 중소기업과 중견기업이 가장 어려워하는 “데이터 주권”, “운영 안정성”, “모델 변경 대응”, “ROI” 문제를 정면으로 다뤘다는 점이 중요합니다.
- 다른 곳에서 잘 말하지 않는 포인트는, AI의 성능보다 “업데이트와 검증이 가능한 구조”가 더 큰 경쟁력이라는 점입니다.
제네시스랩이 지금 하는 일: 딥러닝 회사에서 에이전트 플랫폼 회사로
- 제네시스랩은 원래 채용 인터뷰 분석, 음성 인식, 음성 합성, AI 휴먼 등 다양한 딥러닝 모델을 개발해 온 회사입니다.
- 단순히 한두 개 모델을 만든 수준이 아니라, 10개 이상 모델을 직접 다뤄본 팀이라는 점이 강점입니다.
- 지금은 그 경험을 바탕으로 사내 여러 서비스를 하나로 묶는 Agent Builder를 개발 중입니다.
- 핵심 목표는 기업 내부의 복잡한 업무를 AI 에이전트로 빠르게 만들고, 현업이 바로 검증하고 수정할 수 있게 하는 것입니다.
- 다시 말해, “AI를 만드는 회사”에서 “AI 운영 체계를 만드는 회사”로 이동하고 있는 셈입니다.
왜 온톨로지를 다시 봐야 하나: 그래프보다 중요한 건 ‘설명 가능한 관계’
- 일반적으로 온톨로지는 엔티티, 관계, 트리플, 그래프 같은 형태로 이해됩니다.
- 그런데 실제 현장에서는 모든 것을 복잡한 그래프 구조로 만들 필요가 없다는 문제가 있습니다.
- 제네시스랩 CTO의 관점은 꽤 실용적입니다.
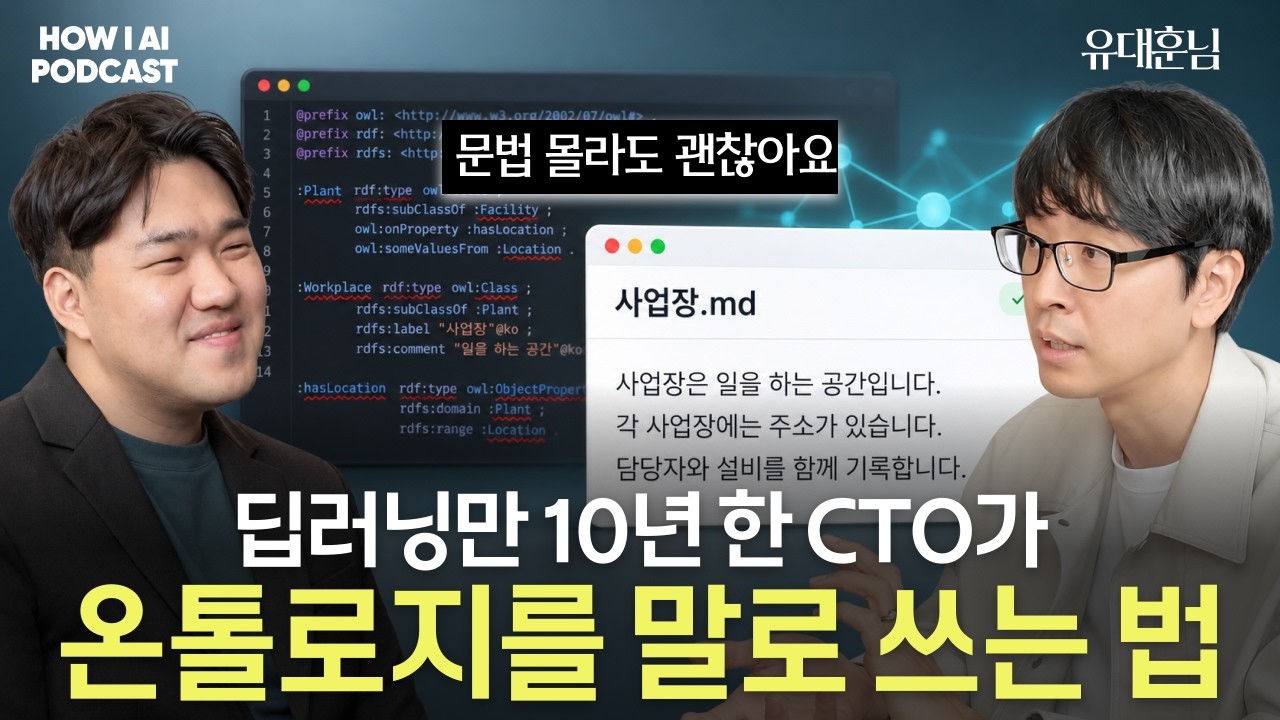
- 중요한 건 그래프 모양이 아니라, 사람이 말로 설명한 관계를 LLM이 이해하고 다시 활용할 수 있느냐입니다.
- 즉, “이 용어는 이런 의미로 쓰인다”, “이 데이터는 이 페이지에 있다”, “이 관계는 이렇게 연결된다”를 자연어로 풀어도 온톨로지 역할을 할 수 있다는 접근입니다.
- 이 방식은 특히 현업 실무자에게 훨씬 친숙합니다.
- 복잡한 온톨로지 스키마를 새로 배우기보다, 업무 언어 그대로 정의하고 연결하면 되기 때문입니다.
슬립박스(Slip Box)의 정체: 지식관리 도구가 아니라 ‘실행 가능한 온톨로지’
- 슬립박스는 단순한 위키나 문서 저장소가 아닙니다.
- 문서, 관계, 용어, 금지 규칙, 쿼리 규칙, 에이전트 실행 흐름까지 함께 관리하는 구조입니다.
- 한마디로 말하면, “문서화된 온톨로지”이자 “AI가 바로 실행할 수 있는 운영형 지식 시스템”입니다.
- 여기서 중요한 건 페이지를 단순히 쌓아두는 게 아니라, 페이지 간 관계를 정의하고 AI가 그 관계를 따라 탐색하게 만든다는 점입니다.
- 이 구조 덕분에 AI는 “어디에 어떤 정보가 있는지”를 더 잘 찾고, 필요한 작업을 실행할 수 있습니다.
왜 슬립박스가 필요했나: 기존 AI 개발 방식의 한계
- 기존 AI 서비스 개발은 보통 프로토타입을 만들고, 개발팀이 정리해서 운영 환경에 올리는 방식이었습니다.
- 그런데 AI는 일반 소프트웨어보다 훨씬 불확실성이 큽니다.
- 사용자가 예측한 방식대로만 쓰지 않기 때문입니다.
- 게다가 현업, AI팀, 개발팀이 따로 움직이면 문제 발견이 늦어집니다.
- 운영에 올라간 뒤에야 오류가 드러나고, 그때 다시 수정하는 구조가 반복됩니다.
- 이 과정은 생각보다 시간이 오래 걸리고, 실제로는 prompt 몇 줄로 해결될 문제도 운영 기준으로 보면 하루, 일주일, 때로는 더 길어질 수 있습니다.
- 그래서 나온 해법이 “현업이 직접 보고 바로 수정 가능한 범용 Agent Builder”였습니다.
제네시스랩 방식의 핵심 구조: Abilities, Agent, Data Layer
- 이 회사는 워크플로우를 그냥 워크플로우라고 부르지 않고, “Ability”라는 개념으로 나눴습니다.
- 즉, 하나의 흐름 안에 들어가는 기능 단위를 모듈처럼 분리해두는 방식입니다.
- 이후 이 Ability들을 Agent 레이어에서 도구처럼 붙였다 뗐다 할 수 있게 구성합니다.
- 여기서 중요한 건 “기능의 모듈화”와 “버전 관리”입니다.
- AI 모델이 바뀌거나 도구가 바뀌어도 전체 시스템을 다시 뜯어고치지 않도록 설계한 겁니다.
- 그리고 그 아래에는 데이터 레이어가 있습니다.
- 이 부분에서 벡터DB, 임베딩, 문서 구조, 메타데이터, 관계 정보가 함께 작동합니다.
다른 곳이 잘 말하지 않는 핵심: AI는 성능보다 ‘변경 비용’이 더 무섭다
- 대부분은 AI 성능만 이야기하지만, 실제 현업에서 더 무서운 건 모델 변경 비용입니다.
- 임베딩 모델이 바뀌면 다시 인덱싱해야 하고, 데이터가 바뀌면 재처리가 필요합니다.
- 한 번 구축한 구조가 매주, 매달 바뀌는 환경이라면 벡터DB만으로는 운영이 매우 부담스럽습니다.
- 특히 중소기업은 GPU 서버 운영, 버전 교체, 회귀 테스트까지 감당하기가 쉽지 않습니다.
- 그래서 이 팀은 “전부 벡터화”보다 “정적 데이터는 구조화해서 관리하고, 필요한 부분만 AI가 보완하는 하이브리드 방식”을 택했습니다.
- 이게 실전에서는 훨씬 현실적입니다.
슬립박스가 해결한 문제 1: 문서를 ‘그냥 저장’하지 않고 관계까지 만든다
- 슬립박스는 파일을 넣는 것에서 끝나지 않습니다.
- PDF, Excel, PPT, 텍스트, 데이터베이스 구조 등 다양한 입력을 받아서 의미 단위로 쪼개고 연결합니다.
- 특히 “원문 보존(Preserve Original Text)” 기능이 중요합니다.
- 법률 문서처럼 단어 하나만 바뀌어도 의미가 바뀌는 경우, 원문을 최대한 유지한 채 구조화해야 합니다.
- 동시에 문서를 페이지별, 주제별, 관계별로 재구성해 AI가 이해할 수 있는 형태로 바꿉니다.
- 즉, 사람은 원문을 보고 안심하고, AI는 구조화된 정보로 작업할 수 있게 만드는 방식입니다.
슬립박스가 해결한 문제 2: 용어 정의가 곧 AI 성능이다
- 현업에서 같은 단어가 서로 다른 의미로 쓰이는 경우가 정말 많습니다.
- 예를 들어 “파리”라는 단어도 나라, 도시, 지역 등 맥락에 따라 다르게 해석됩니다.
- 기업 데이터도 마찬가지입니다.
- 같은 “사업자등록번호”라도 테이블마다 의미가 조금씩 다를 수 있습니다.
- 슬립박스는 이런 용어를 명시적으로 정의해 둡니다.
- LLM은 정의를 보고 그 이후부터는 그 의미대로 해석합니다.
- 이게 생각보다 엄청 중요합니다.
- AI가 잘못된 용어 정의를 학습하면 이후 모든 질의가 흔들리기 때문입니다.
슬립박스가 해결한 문제 3: DB와 MD를 함께 써서 속도와 일관성을 동시에 잡는다
- 단순 문서 기반 위키는 사람이 이해하기는 좋지만, 검색과 일관성 관리가 약할 수 있습니다.
- 반대로 DB로만 관리하면 AI가 바로 이해하기 어려울 수 있습니다.
- 이 팀은 둘을 섞었습니다.
- DB에서 일관성을 관리하고, 필요한 부분은 다시 Markdown으로 렌더링해 AI가 읽게 합니다.
- 이렇게 하면 검색 속도, 정합성, 편집 편의성, 설명 가능성을 같이 가져갈 수 있습니다.
- 이 구조는 꽤 실전적입니다.
- 단순히 “AI 친화적”이 아니라 “운영 가능한 AI 친화성”을 만든 셈입니다.
검증은 어떻게 하느냐: Bulk Test와 Zero Click이 핵심
- AI는 만들어 놓고 끝이 아니라 검증이 더 중요합니다.
- 제네시스랩은 Bulk Test 기능을 통해 능력(Ability)이 정답과 맞는지 대량으로 검증합니다.
- 여기에 더해 Zero Click이라는 개념도 강조합니다.
- 사용자가 일일이 복잡한 설정을 하지 않아도, 입력값 기반으로 가상 테스트를 돌리고 결과를 확인하는 방식입니다.
- 현업이 “이게 맞는지”를 빠르게 보고, 문제가 있으면 바로 수정할 수 있습니다.
- 이건 단순한 QA가 아니라, AI 운영의 자동화에 가깝습니다.
Text-to-SQL과 설명 가능한 AI가 왜 다시 중요해졌나
- 현장에서는 생각보다 Text-to-SQL 수요가 높습니다.
- 데이터팀만 쓸 줄 알았던 기능이 아니라, 현업이 직접 데이터 조건을 묻고 싶어 하는 상황이 많기 때문입니다.
- 그런데 Text-to-SQL은 잘못 만들면 위험합니다.
- 테이블 구조를 제대로 모르면 엉뚱한 쿼리가 나오고, 실무에서는 이게 곧 신뢰도 하락으로 이어집니다.
- 그래서 슬립박스처럼 테이블 정의, 금지 규칙, 질의 규칙을 함께 관리하는 구조가 필요합니다.
- 특히 최근 AI 규제와 설명 가능성 요구가 커지면서, “왜 이런 결과가 나왔는지”를 보여주는 구조가 중요해졌습니다.
기업 입장에서 가장 중요한 포인트: AI의 자산화
- 이 대화에서 가장 크게 봐야 할 건 “AI를 개인 능력이 아니라 회사 자산으로 바꾸는 법”입니다.
- 많은 기업이 AI 도입은 했지만, 실제로는 특정 직원의 프롬프트 능력에 의존하는 경우가 많습니다.
- 그러면 퇴사하거나 부서가 바뀌면 자산이 사라집니다.
- 슬립박스와 Agent Builder는 이 문제를 정면으로 해결하려고 합니다.
- 즉, 개인 노하우를 시스템화하고, 회사 전체가 재사용할 수 있는 구조로 바꾸는 겁니다.
- 이게 진짜 ROI를 만드는 방식입니다.
중소기업과 중견기업에 특히 중요한 이유
- 대기업은 데이터레이크 통합이나 전사 플랫폼 구축이 가능할 수 있습니다.
- 하지만 중소기업과 중견기업은 다릅니다.
- 데이터 주권, 기존 시스템 유지, 비용, 인력 부족, 운영 복잡성이 훨씬 더 민감합니다.
- 그래서 “전부 갈아엎는 방식”은 현실적이지 않습니다.
- 제네시스랩의 접근은 기존 시스템을 최대한 활용하면서, 필요한 부분만 온톨로지와 에이전트로 연결하는 방식입니다.
- 이건 규모가 작은 조직일수록 더 유효한 전략입니다.
정리하면: 슬립박스는 AI 검색 도구가 아니라 기업 운영 체계다
- 슬립박스의 본질은 검색이 아닙니다.
- 문서를 찾는 도구를 넘어, 용어를 정의하고, 관계를 만들고, 검증하고, 수정하고, 실행까지 연결하는 운영 체계입니다.
- 온톨로지를 그래프로만 보지 않고, 말로 설명 가능한 페이지 관계로 재해석한 점이 핵심입니다.
- 이 방식은 AI가 잘 작동하게 만드는 동시에, 사람이 이해하고 통제할 수 있게 합니다.
- 결국 미래의 AI 경쟁력은 “모델 성능”보다 “업데이트 가능한 구조”, “설명 가능한 구조”, “현업이 직접 만질 수 있는 구조”에 달려 있습니다.
다른 유튜브나 뉴스에서 잘 말하지 않는 가장 중요한 내용
- 대부분의 AI 콘텐츠는 “무슨 모델이 좋다”, “성능이 올랐다” 수준에서 끝납니다.
- 그런데 실제 기업 현장에서는 그보다 더 중요한 게 있습니다.
- 바로 누가 수정할 수 있는지, 어디까지 설명할 수 있는지, 바뀌었을 때 얼마나 빨리 복구할 수 있는지입니다.
- 제네시스랩 사례가 중요한 이유는, AI를 멋지게 보여주는 게 아니라 “운영 가능한 시스템”으로 만들었다는 데 있습니다.
- 다시 말해, AI 시대의 경쟁력은 똑똑한 답변이 아니라 “지속 가능한 통제력”입니다.
- 이 부분은 정말 많은 기업이 놓치고 있습니다.
< Summary >
- 제네시스랩은 온톨로지를 그래프가 아니라 말과 문서로도 운영 가능한 구조로 재해석했습니다.
- 슬립박스는 문서 저장소가 아니라, 용어·관계·검증·실행을 묶는 AI 운영 체계입니다.
- 핵심 가치는 성능보다 변경 비용, 설명 가능성, 현업 주도 수정 가능성입니다.
- 중소·중견기업에 특히 유리한 하이브리드 AI 자산화 전략입니다.
[관련글…]
*출처: 빌더 조쉬 Builder Josh
답글 남기기